书籍介绍
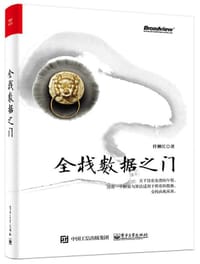
这本书最打动人的地方,是作者把数据科学当成一条完整的链路来讲——从数据从哪里来、如何落地存储,到用SQL、awk、Pandas三种等价工具做分析,再到集群、分布式、负载均衡的系统架构,最后落到Spark上的机器学习。它不追求在某一点上钻得极深,而是刻意拼出「全栈」的地图:让读者看清数据从产生到加工的完整旅程。正因如此,它更像一本技术文集,适合刚入行、想建立全局观的人快速定位自己该往哪个方向走。但争议也在于此:有人嫌它不够深入,有人不满作者穿插的佛学、八卦与小说闲笔。它适合那些愿意自己补专业深度、只想先拿到钥匙的人,而非寻求系统训练的学习者。
电子工业出版社的其他书籍查看全部
下载
收藏