
书籍介绍
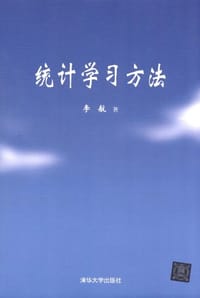
翻开这本书,最先撞进眼里的是满页的定理编号与算法推导:感知机的Novikoff定理、kd树的最近邻搜索、EM算法的Q函数,几乎每一章都把「模型—策略—算法」三层拆得清清楚楚。它最大的魅力,正在于这种近乎苛刻的严谨——不满足于告诉你某个算法怎么用,而是逼你理解它为什么成立。但这也构成了它最鲜明的门槛:有读者直呼「数学功底不深厚的不建议看」,也有人抱怨它「只讲道理、不讲故事」,看完仍不清楚这些算法究竟能拿来做什么。因此它适合的是愿意啃公式、追求「知其然更知其所以然」的人,而非只想速成调参的入门者。若你能熬过前几章的推导,它会还你一套逻辑自洽、可溯源的机器学习知识体系。
作者简介
李航,男,毕业于日本京都大学电气电子工程系,日本东京大学获得计算机科学博士学位。北京大学、南京大学兼职教授。曾任日本NEC公司中央研究所研究员,微软亚洲研究院高级研究员与主任研究员、华为技术有限公司诺亚方舟实验室主任。现任今日头条人工智能实验室主任。
AI导读
核心看点
- 系统涵盖感知机、SVM等监督学习及聚类、SVD等无监督学习核心算法
- 从具体问题入手,由浅入深阐明思路,提供必要的数学推导与公式证明
- 内容精简干练,侧重原理阐述与算法逻辑,是统计学习领域的经典教材
读者共识
- 国内统计学习领域公认的经典教材,内容严谨,被誉为入门必读之作
- 风格言简意赅,干货满满但缺乏背景故事,对初学者不够友好
- 虽被部分读者认为过于简略,但作为查阅手册和夯实基础的工具书极佳
精彩摘录
- "定理 2.1 (Novikoff) 设训练数据集 T={(𝑥₁,𝑦₁), (𝑥₂,𝑦₂), ..., (𝑥_N, 𝑦_N)} 是线性可分的, 其中 𝑥ᵢ∈𝒳=ℝⁿ, 𝑦ᵢ∈𝒴={-1,+1}, i=1,2,...,N, 则 (1) 存在满足条件 ||{\hat w}_{opt}||=1 的超平面 {\hat w}_{opt} \dot \hat x = w_opt \dot x + b_{opt} = 0 将数据集完全分开; 且存在 γ>0, 对所有 i=1,2,...,N ..."
- "算法 2.2 (感知机学习算法的对偶形式) ... (3) 如果 y_i(\sum_{j=1}^N \alpha_j y_j x_j \dot x_i+b) \le 0, \alpha_i \leftarrow \alpha_i+\eta b \leftarrow b + \eta y_i"
- "算法 3.3 (用 kd 树的最近邻搜索) ... (3) ... (b) 当前最近点一定存在于该节点一个子节点对应的区域. 检查该子结点的另一个子结点对应的区域是否有更近的点. 具体地, 检查另一子结点对应的区域是否与以目标点为求新, 以目标点与"当前最近点"的距离为半径的超球体相交."
- "3.3 参照算法 3.3, 写出输出为 x 的 k 近邻的算法"
- "Q(\theta, \theta^{i}) = E_{Z}[\log P(Y, Z|\theta)Y, \theta^{i}] = \sum_{Z}\log P(Y, Z|\theta)P(Z|Y, \theta^{i})"
- "第2章 感知器"
- "第3章 K近邻"
- "第4章 朴素贝叶斯"
目录
用户评论
特别棒,绝大部分部分内容清晰明了,还有非常丰富的扩展阅读,不过大多都是传统机器学习内容,如果再加上一本专门讲神经网络深度学习的书的话才算是把目前主流机器学习内容学全。
中式教材,不适合初学者读。所有算法都是只讲道理,不讲故事,如果不了解背景故事,真的很难明白到底这些算法能拿来干嘛。
很中国
只恨太晚看第一章
主要看了新增的无监督学习部分,说实话新增加的内容有点儿水,价格倒是涨了不少。
公式书,工具书。没有啰嗦和冗余,适合做参考,系统的学习机器学习还需要其他资料补充。另外有些新的算法没收录。
反反复复,复复反反。ml学习必备中文书籍。
国内统计学习教科书的天花板
快读完了 写得很牛
同时在看西瓜书和这本书,我自己觉得这本书更好,更能做到从简入深。但是不好的地方是难度有点高,很多地方省略了没展开,不适合本科生。

清华大学出版社的其他书籍查看全部
下载
收藏