书籍介绍
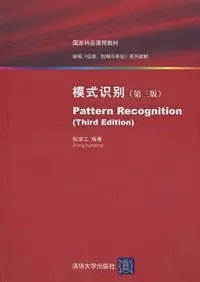
作为清华自动化系国家精品课程的配套教材,本书在业内口碑两极分化:有人称其"该讲的都讲了,提纲挈领不废话",也有人直言"SVM与核函数讲得太水"。这种评价的分歧恰恰揭示了它的定位——它不是一本让你轻松翻完的入门读物,而是一本需要数理统计与优化基础、最好先修过机器学习的硬核教材。读者普遍反馈,第一遍读时需要自行补充大量内容、按算法脉络重新整理才能看清演进逻辑,部分主流内容(如GMM)有所缺失。它的价值在于系统性和作者自身研究案例的实例化,性价比突出;它的局限在于年代偏老、没有代码、深度内容参差。适合有一定基础、想系统建立模式识别知识框架的本科生与研究生,而非零基础速成者。
作者简介
张学工
1994年于清华大学模式识别与智能系统专业获工学博士学位,现任清华大学自动化系教授。主要从事机器学习的理论、方法与应用研究和生物信息学研究。
AI导读
编辑书评
- 本书的真正价值在于以精炼的篇幅重构了模式识别的经典范式,填补了国内高质量原创教材的空白。它好在‘骨架清晰’,将散乱的算法归纳为监督与非监督两大主线,便于读者建立宏观视野。局限在于‘血肉不足’,关键推导的跳跃性和对现代深度学习关联性的缺失,使其难以独立支撑高阶科研需求。相比Duda的厚重与PRML的晦涩,本书胜在可读性与本土化表达,是极佳的‘第一本’模式识别书,但绝非‘最后一本’。
- 作为编辑,我认为此书值得所有AI方向学生通读一遍,用以校准知识地图。它不适合用于解决具体工程Bug或追求SOTA模型复现,但在面试准备、课程复习及跨领域转行时具有不可替代的效率优势。争议点在于其‘教学理想主义’与‘自学现实困难’之间的落差:作者试图面面俱到,却牺牲了细节展开。因此,最佳使用场景是配合习题集或在线课程,将其作为理论索引而非唯一信源,方能发挥其‘清华系严谨逻辑’的最大效用。
核心看点
- 本书作为清华大学国家精品课程教材,核心优势在于构建了从统计决策理论到现代机器学习算法的完整知识图谱。它不仅涵盖贝叶斯决策、线性/非线性分类器等经典内容,更将SVM、Boosting、随机森林等前沿方法有机融入传统模式识别框架,体现了‘系统性’与‘实用性’并重的编写意图,旨在帮助读者建立扎实的理论根基而非仅仅罗列算法。
- 作者张学工教授在书中展现了鲜明的个人学术思考,区别于单纯的翻译或拼凑式教材。通过引入大量基于自身研究案例的实例分析,以及对非监督学习、特征选择提取等难点的深度剖析,试图解决国内教材普遍存在的‘重公式轻直觉’问题。这种写法意在引导读者理解算法背后的物理意义和工程适用场景,而非止步于数学推导。
- 该书强调‘薄而精’的教学理念,适合快速构建知识体系。相较于Duda《模式分类》或PRML等大部头著作,本书篇幅适中,推导过程虽偶有省略但主干清晰,特别适合作为研究生入门或本科生高年级进阶的桥梁书。其核心价值在于用中文语境梳理了模式识别的脉络,降低了语言门槛,同时保留了足够的深度供后续深入钻研。
读者共识
- 读者普遍认可其‘国产精品’地位,认为文笔通顺、逻辑清晰,优于许多翻译版教材。多数评论指出其性价比高,内容全面且提纲挈领,特别适合中国学生的思维习惯。然而,也有相当一部分读者批评其推导过程过于简练,甚至出现‘会者易懂,不会者难通’的现象,尤其是对非线性分类器和部分算法改进过程的省略引发争议。
- 关于适用人群的评价呈现两极分化:高分读者多将其视为优秀的入门桥梁或复习纲要,称赞其结构合理;低分读者则抱怨其不适合自学,认为缺乏例子和代码,且部分内容陈旧或错误(如SVM核函数讲解不连贯)。共识在于它是一本合格的‘教材’而非完美的‘自学指南’,需要读者具备较强的自主补课能力。
- 读者一致肯定其在统计模式识别领域的经典性,认为其对贝叶斯决策、参数/非参数估计的讲解比某些国外名著更接地气。但对于前沿技术的覆盖度存在分歧,部分用户认为其引入了SVM、Boosting等新内容值得点赞,另一部分则认为这些新内容只是点缀,深度远不及专门著作,建议作为索引而非深究对象。
精彩摘录
- "nearby points in the high dimensional space remain nearby and similarly co-located with respect to one another in the low dimensional space"
目录
用户评论
好教材。需要数理统计,最优化的基础,最好先学一门《机器学习》,再看这本书时,就会流畅许多。我对非监督学习的内容接触的少,所以本书最后50页,看得慢了许多。1.面面俱到,该讲的都讲了,提纲挈领不废话 。2.有实例介绍,多为作者自己的研究案例,讲得明白。 3.作者讲出了作者自己对模式识别的思考和想法,不是抄来抄去的拼凑。4.作者是中国人,语言通顺,比翻译版课本易读。
一本尚可的机器学习入门书
部分章节讲得比《模式分类》还更清楚,便宜实惠,性价比高
还不错的,比较全面。清华自动化系很强!
其实也算是比较好的国内教材了,但后来发现基本就是pc的翻译,不如直接看pc。
第一遍看需要自己额外补充很多,整理的话按照具体算法整理会更清晰,比如对于svm自己整理出hard svm, soft margin svm, kernel svm,这样能更好的看出来这个算法怎么改进的。以及有些主流内容有缺失,比如GMM这里缺了EM的介绍,需要搭配别的书一起看。个人觉得总体不适合新手入门,基本没有例子,推导也不详尽,会的看了还是会,不会的看了还是不会。
应付考试而已
读完 最后一门 五星求过🙏🏼
《统计学习方法》精简版,介绍了不少机器学习算法,作为机器学习入门可以。不过本书比较老(比统计学习方法和西瓜书都要早出版),而且书上没有代码,而且要深入研究模式识别还得读PRML。
生动具体 不错
清华大学出版社的其他书籍查看全部