书籍介绍
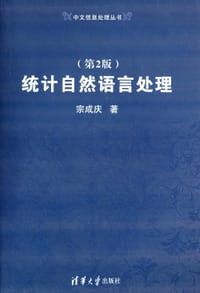
作为中文语境下少有的系统型NLP教材,本书的最大特点在于'全'——从语言模型、隐马尔可夫模型到统计机器翻译、问答系统,几乎覆盖了该领域所有主流方向。但正因如此,它也引发真实争议:不少读者觉得机器翻译篇幅过重、整体风格'中庸'、读来缺乏激情。它的真正价值,或许不在于让你热血沸腾,而在于为入门者提供一条清晰、可依托的路径:隐马尔可夫模型体系构建完整,参考文献丰富,能在你被 Manning 那本经典教材绕晕时及时'拯救'你。适合需要建立知识框架、又希望一站式览尽技术版图的读者;若追求深度专精或阅读激情,则需自行取舍。
AI导读
编辑书评
- 本书的价值在于其“系统性”与“本土化”。在NLP领域长期由英文教材主导的背景下,宗成庆教授以严谨的学术态度梳理了从理论到应用的脉络,尤其是对汉语特有问题的处理具有不可替代性。它并非一本追求新奇的专著,而是一座稳固的知识桥梁,适合那些不满足于调用API、渴望理解算法本质的学习者。尽管被戏称为“写书还是写Survey”,但这种全景式的覆盖恰恰是其作为教材的核心竞争力。
- 然而,必须警惕其“理论脱离实践”的风险。书中大量篇幅用于数学推导,对于急需解决业务问题的工程师而言,性价比可能低于直接阅读最新论文或开源项目文档。此外,随着深度学习重塑NLP格局,书中基于传统统计模型(如SVM、HMM)的内容虽具历史意义,但在现代工业界的应用场景已大幅缩减。因此,它更适合作为构建底层认知的基石,而非追逐前沿技术的指南针。
核心看点
- 本书构建了从形式语言、概率论到具体应用(如机器翻译、问答系统)的完整知识图谱,特别强调统计方法背后的哲学基础——经验主义与理性主义的对比,帮助读者理解为何统计NLP成为主流。
- 针对汉语处理痛点,书中详细阐述了自动分词、词性标注及句法分析等本土化技术,弥补了国外经典教材在中文语境下的不足,为从事中文信息处理的工程师提供了可落地的理论支撑。
- 内容涵盖隐马尔可夫模型、支持向量机等核心算法推导,并延伸至语音识别、文本分类等前沿领域,虽被部分读者诟病为“综述式”写法,但其严谨的参考文献和体系化梳理极具学术参考价值。
读者共识
- 普遍认可其作为中文NLP入门教材的地位,认为作者宗成庆治学严谨,参考文献丰富,是少数能替代国外经典教材且贴合国内教学需求的优质著作。
- 批评声音主要集中在“中庸”与“无新意”,许多读者指出内容多为现有技术的汇总而非原创突破,读起来像一篇长篇Survey,缺乏激情与深度洞察。
- 关于难度两极分化:有背景者视其为理论升华的良伴,而初学者则抱怨不够深入浅出,常将其与Jurafsky的综论对比,认为后者更适合零基础入门。
精彩摘录
- "其实,在很多情况下,用户并不想搜索文献的全文,而只是想知道某一个具体问题的确切答案,诸如:北京故宫建于哪一年?NASDAQ的英文全称是什么?美国现任总统是谁?等等。这种能够接受用户以自然语言形式描述的提问,并能从大量的异构数据中查找或推断出用户问题答案的信息检索系统称为问答系统(question answering,QA) 从某种意义上说,问答系统是集知识表示、信息检索、自然语言处理和智能推理等技术于一身的新一代搜索引擎。"
- "基于统计的自然语言处理的理论基础是哲学中的经验主义,基于规则的自然语言处理的理论基础是哲学中的理性主义。"

清华大学出版社的其他书籍查看全部