书籍介绍
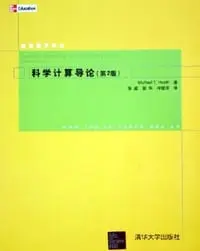
这不是一本教你'如何套用公式'的数值分析教材,而是一本训练你'判断何时该用、何时不该用'的算法鉴赏指南。全书最大的价值在于反复追问同一个问题:同一个数学问题,为什么有的算法稳定、有的却崩溃?作者希思把'病态性'和'敏感性'置于核心位置,提醒读者——结果不准未必是算法选错,而可能是问题本身就在放大误差。配合大量例题与偏难的课后题,它逼着你亲手验证理论,从而建立起对算法的直觉与批判力。适合工科背景、重计算而轻证明、希望真正理解'数值方法为何有效'的读者;若你只想要现成公式速查,这里可能让你'快看哭了'。
AI导读
编辑书评
- 《科学计算导论》的真正价值不在于罗列算法,而在于传授一种‘数值思维’。在AI与大数据时代,盲目调用库函数往往导致灾难性错误,希思教授通过强调敏感性与病态性,迫使读者审视输入数据的微小扰动如何放大为输出结果的巨大偏差。这种对‘不确定性’的敬畏,是区分合格程序员与优秀科学计算专家的分水岭。它不是一本教你怎么写的书,而是一本教你怎么‘避坑’的书,其教育意义远超技术层面。
- 相较于同类教材如Burden & Faires的《Numerical Analysis》,本书更偏向计算机科学视角,弱化了严格的误差界证明,强化了算法的可实施性与软件生态关联。然而,其局限也源于此:对于需要深厚理论支撑的研究型学者,本书略显浅尝辄止。此外,中文译本的硬伤不容忽视,建议读者在阅读时保持警惕,最好对照原版或结合在线资源使用。总体而言,它是工科生进入数值世界的高性价比门票,但不适合作为唯一的理论基石。
核心看点
- 本书核心在于培养算法鉴赏力而非单纯记忆公式。它强调‘敏感性’与‘病态性’概念,深入剖析同一问题下不同算法的适用边界(何时Work、何时失效),帮助读者建立对数值稳定性的直觉判断,这是区别于传统纯数学教材的关键视角。
- 采用‘应用导向’的教学逻辑,大幅削减繁琐的定理证明,转而聚焦于算法背后的思想原理与实际计算效果。书中通过160多道例题和大量习题,将抽象的线性代数、微分方程求解转化为可操作的计算流程,特别适合工科背景读者快速掌握解决工程计算问题的工具链。
- 构建了完整的科学计算知识图谱,涵盖从基础插值积分到复杂的FFT及随机数生成。其独特价值在于不仅讲解理论,还专门讨论相关数学软件平台的选择与应用,实现了从‘纸上推导’到‘代码实现’的桥梁搭建,为研究生入门或科技人员实战提供了极具参考价值的框架。
读者共识
- 读者普遍认可其‘直观易懂’与‘贴近实践’的风格,认为它是搭建数值分析知识框架的必读经典。相比国内传统教材的晦涩,本书更注重解释‘为什么选这个算法’以及‘这个算法什么时候会出错’,这种实用主义导向获得了工科背景读者的广泛好评。
- 争议点集中在‘基础’定义的认知偏差上。部分初学者觉得内容艰深甚至‘快看哭’,而资深用户则认为其偏重计算、证明简略。共识在于:它不是零基础的科普书,而是需要一定数学成熟度的进阶教材,其难度体现在对算法细节的把控而非高深的理论推导。
- 对译本质量的批评较为集中,多位读者指出存在不少印刷错误和公式笔误。尽管原书被公认为经典且值得一读,但中文版的瑕疵影响了阅读体验。读者建议将其作为参考书而非唯一自学材料,或在发现疑点时及时查证,以免被错误信息误导。
精彩摘录
- "An inaccurate solution is not necessarily due to an ill-conceived algorithm,but may be inherent in the problem being solved. Even with exact computation, the solution to the problem may be highly sensitive to perturbations in the input data. The qualitative notion of sensitivity, and its quantitativ"
用户评论
对我帮助非常大的一本书,感觉内容很棒,我自己看肯定是看不下来,还好有老师帮忙带着学
: O241
告一段落.
第一本数值分析
唉,如果课后习题越难书越赞的话,那就五星吧...
搭建知识框架必读
错误不少。原书值得一读。
清华大学出版社的其他书籍查看全部