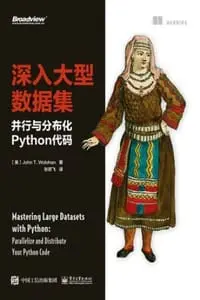
内容简介
《深入大型数据集:并行与分布化Python代码》共分3部分,主要介绍如何使用Python语言来处理大型数据集。第1部分介绍map和reduce编程风格,以及Python中基础的map和reduce函数,并介绍如何将对象持久化,通过惰性函数和并行函数来加快大型数据集的处理速度。第2部分介绍Hadoop和Spark框架,以及如何使用mrjob库来编写Hadoop作业,如何实现PageRank算法,如何使用Spark来实现决策树和随机森林的机器学习模型。第3部分重点介绍云计算和云存储的基础知识,包括如何通过boto3的Python库将文件上传到AWS S3服务,以及如何在AWS的EMR集群中运行分布式的Hadoop和Spark作业。
《深入大型数据集:并行与分布化Python代码》适合有一定Python编程基础,且希望掌握大型数据集处理能力的开发人员和数据科学家阅读。
J.T. Wolohan是Booz Allen Hamilton公司的一名高级人工智能和自然语言处理架构师。他教过各种层次的学生学习编程:从小学、初中学生到研究生、专业人士。除对分布式和并行计算感兴趣之外,J.T.还喜欢跑步、烹饪和与家人共度时光。
译者简介
张若飞,曾任多家互联网金融公司CTO,在宜人贷、雅虎北研、金山云等知名公司担任架构师。十余年互联网研发及技术管理经验,对搭建海量数据、大型分布式系统有丰富经验。著有十余本技术译著,包括《Grails权威指南》《给大忙人看的JavaSE8》《代码不朽:编写可维护软件的十大原则》《面向可伸缩架构》《云原生Java》《云原生模式》等书,总计400余万字。
目录
读者评论
对mapReduce的讲解大师级般循循善诱,深入浅出。后面pyspark和mrjob就显得比较粗糙
MapReduce 的部分写的还可以, 这本书所有的精华也就在前 150 页了, 后面说PySpark 总有一种写不够凑数的感觉. 而且数据科学中的一部分 MapReduce 算法其实已经被吸收进了 Split-Compute-Combine 的体系内, 所以全文看着就有点隔靴搔痒. 但是有志于了解 FP 的, 可以作为一个小入门, 然后去看函数式编程. 不得不说, Python FP 最大的败笔就在于符号太差, F# 有 |> R 有 %>% 而 Python 还得用个 pipe 或者 compose.
电子工业出版社的其他书籍查看全部
 《学习观 : 从感觉懂了到真正学会》
 《货币银行学(第2版)》
 《GEO不是你想的那样:AI决策时代的增长重构》
 《更年有方:重塑肠道微生态,稳稳过好更年期》
 《AI时代的个人成长·投资·财富自由》
 《世界模型》