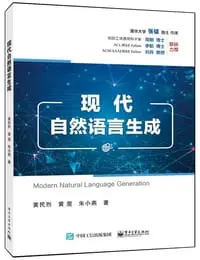
内容简介
本书总结了以神经网络为代表的现代自然语言生成的基本思想、模型和框架。本书共12 章,首先介绍了自然语言生成的研究背景、从统计语言模型到神经网络语言建模的过程,以及自然语言建模的思想与技术演化过程;其次从基础模型角度介绍了基于循环神经网络、基于Transformer 的语言生成模型,从优化方法角度介绍了基于变分自编码器、基于生成式对抗网络的语言生成模型,从生成方式角度介绍了非自回归语言生成的基本模型和框架;然后介绍了融合规划的自然语言生成、融合知识的自然语言生成、常见的自然语言生成任务和数据资源,以及自然语言生成的评价方法;最后总结了本书的写作思路及对自然语言生成领域未来发展趋势的展望。 本书可作为高等院校计算机科学与技术、人工智能、大数据等相关专业高年级本科生、研究生相关课程的教材,也适合从事自然语言处理研究、应用实践的科研人员和工程技术人员参考。
作者简介
黄民烈,博士,清华大学计算机科学与技术系长聘副教授。主要研究兴趣包括人工智能、自然语言处理,尤其是对话系统、语言生成。曾获中国人工智能学会吴文俊人工智能科技进步奖一等奖(****)、中文信息学会汉王青年创新奖,多次在国际主流会议获得最佳或杰出论文奖。研发对话系统平台ConvLab和ConvLab-2,获得NTCIR 2017年组织的短文本对话生成评测冠军。担任神经领域顶级期刊TNNLS(SCI一区,影响因子>11)编委,自然语言处理领域顶级期刊TACL执行编辑,多次担任自然语言处理顶级会议ACL、EMNLP的领域主席或资深领域主席。
AI 导读
编辑书评
- 本书的真正价值在于其罕见的‘结构化思维’。在NLP教材普遍陷入‘罗列最新模型’的同质化陷阱时,作者选择回归第一性原理,以‘条件概率建模’为主线,将纷繁复杂的生成技术归纳为基础模型、优化方法、生成方式三个维度。这种分类法不仅逻辑自洽,更揭示了技术演化的内在因果链——例如为何非自回归尝试效果受限,实则是自回归优势的反证。对于渴望透过热点迷雾看清技术本质的研究者,这是一份难得的清醒指南。
- 然而,本书的局限性同样明显:它是一本优秀的‘教科书’,却非完美的‘实战手册’。后半部分为了追求覆盖面,牺牲了深度,许多前沿议题仅点到为止,缺乏足够的实验洞察与批判性分析。此外,随着大模型时代的到来,书中部分传统小模型技术的权重正在下降。因此,它最适合用于构建理论地基和应对学术考试/面试,但若你急需解决具体的工业级生成难题,仍需配合最新的顶会论文与开源社区实践共同使用。
核心看点
- 本书构建了以‘文本条件概率建模’为核心的严谨知识体系,区别于泛泛而谈的NLP综述。它从统计模型演进到神经网络,系统梳理了RNN、Transformer等基础架构,并深入解析VAE与GAN在语言生成中的优化机制,逻辑链条清晰完整,适合建立底层认知框架。
- 内容覆盖极具前沿性与结构性,不仅包含主流自回归模型,还专门探讨了非自回归生成、融合规划与知识的生成范式。这种多维度的分类方式(基础模型、优化方法、生成方式)帮助读者跳出单一算法视角,理解自然语言生成技术演化的内在驱动力与不同流派的技术权衡。
- 评价方法论的系统化整理是本书一大亮点。除了模型介绍,书中详细阐述了NLG的评价指标与数据资源,填补了多数教材重模型轻评估的空白。对于科研人员和工程落地者而言,掌握如何科学地衡量生成质量,比单纯堆砌模型参数更具实际指导意义。
读者共识
- 读者普遍认可本书的结构化与严谨性,认为其是优质的DL+NLP学习材料。多位评论指出,相比同类书籍,本书叙述逻辑更清晰,公式注解详尽,适合作为自学的基础骨架。黄民烈老师的学术声誉也为本书的质量提供了背书,被视为‘必须认真读’的专业著作。
- 存在明显的‘前后差异’共识:前半部分(RNN/Transformer/VAE/GAN)讲解深入透彻,备受好评;而后半部分被指‘大而全但细节一笔带过’,insight略显不足。部分读者认为其在非自回归等新兴领域的探讨不够深入,更像是一份高质量的文献综述而非深度专著。
- 尽管有批评声音,但整体评价仍偏向正面,尤其是与刘知远等学者的同类著作相比,本书被认为更加‘走心’和系统。读者认为其最大价值在于提供了一个完整的知识地图,虽不能替代所有前沿论文,但对于建立系统性认知框架具有不可替代的作用。
电子工业出版社的其他书籍查看全部
 《学习观 : 从感觉懂了到真正学会》
 《货币银行学(第2版)》
 《GEO不是你想的那样:AI决策时代的增长重构》
 《更年有方:重塑肠道微生态,稳稳过好更年期》
 《AI时代的个人成长·投资·财富自由》
 《世界模型》