

书籍介绍
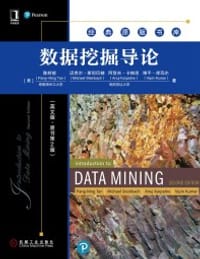
翻开这本书,你大概会经历一次对“自己是否适合学数据挖掘”的重新认识。读者普遍反馈:它确实把分类、关联、聚类、异常检测这几条主线讲得清楚,也擅长用“尿布与啤酒”、辛普森悖论、召回率与F1这类具体场景把抽象概念钉住;但中译本生硬的术语处理,常让人在条件状语从句和数据度量上卡壳,甚至有读者被迫回头啃英文原著。它不是一本让人轻松的入门书,而更像一本需要配合代码与案例、带着数学底子啃的工具书。适合那些愿意慢下来、把“为什么这样度量、如何评估模型”想明白的人;若只想快速上手跑算法,或许会感到痛。
作者简介
Pang-Ning Tan现为密歇根州立大学计算机与工程系助理教授,主要教授数据挖掘、数据库系统等课程。此前,他曾是明尼苏达大学美国陆军高性能计算研究中心副研究员(2002-2003)。
Michael Steinbach 明尼苏达大学计算机与工程系研究员,在读博士。
Vipin Kumar明尼苏达大学计算机科学与工程系主任,曾任美国陆军高性能计算研究中心主任。他拥有马里兰大学博士学位,是数据挖掘和高性能计算方面的国际权威,IEEE会士。
AI导读
核心看点
- 涵盖分类、关联、聚类等五大核心主题
- 侧重解决实际问题,弱化复杂数学推导
- 结构清晰,从基础概念延伸至高级算法
读者共识
- 内容全面且浅显易懂,是极佳的入门教材
- 中文版翻译灾难,严重劝退,请慎选
- 理论描述较多,需配合具体案例辅助理解
精彩摘录
- "data mining is an integral part of knowledge discovery in databases(KDD), which is the overall process of converting raw data into useful information"
- "精度通常用值集合的标准差度量"
- "例27 澳大利亚降水量"
- "设x和y是两个点,其中y是原来的点,而x是它的某个失真或近似,例如,x可能是由于添加了一些随机噪声到y上而产生的。损失函数的目的是度量用x近似y导致的失真或损失。当然,x和y越类似,失真或损失就越小,因而Bregman散度可以用作相异性函数。"
- "是一个函数与该函数线性近似之差"
- "像最近邻这样的消极学习方法不需要建立模型,然而,分类测试样例的开销很大,因为需要逐个计算测试样例和训练样例之间的相似度。 最近邻分类器基于局部信息进行预测,而决策树和基于规则的分类器试图找到一个拟合整个输入空间的全局模型。正式因为这样的局部分类决策,最近邻分类器(k很小时)对噪声非常敏感。 最近邻分类器可以生成任意形状的决策边界,这样的决策边界与决策树和基于规则的分类器通常所局限的直线决策边界相比,能提供更灵活的模型表示。 除非采用适当的临近性度量和数据预处理,否则最近邻分类器可能做出错误的决策。"
- "数据挖掘是在大型数据存储库中,自动地发现有用信息的过程。 并非所有的信息发现任务都被视为数据挖掘。"
- "数据挖掘任务分为预测任务和描述任务两大类。预测任务的目标是根据其他属性的值,预测特定属性的值。描述任务的目标是导出概述数据中潜在联系的模式(相关、趋势、聚类、轨迹和异常)。"
目录
用户评论
:TP311.13/7242-4
入门资料
两位翻译绝对是不会翻译条件状语从句的。匆忙看了一遍发现这完全是两个世界的思维。
缺乏统计学基础,真是看的痛不欲生
作为数据挖掘入门书籍挺好,概念讲得很全,也易懂,非数据挖掘方向的人士表示阅读没有鸭梨。
讲得过于简单了,真正的“导论”,导完了很多东西还是不知道
谁让我看不懂英文原书呢😢
粗略的看完了,写的比较通俗易懂。
数据挖掘课本
工具书




下载
收藏