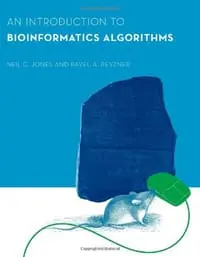
An Introduction to Bioinformatics Algorithms
出版时间
2004-08-06
ISBN
9780262101066
文件格式
评分
★★★★★
内容简介
这本书最耐人寻味的地方,恰恰是它「浅」的姿态。它不追求把每一道生物问题都讲透,而是刻意用少数几类算法设计技巧,串起一大片看似零散的实际问题,让读者看清「原来这么多难题背后是同一套思路」。正因如此,它特别适合刚入门、尚未建立知识框架的学生:本科课堂、导师强推、自学补基础,都能找到合适的位置。但它的浅也意味着取舍——部分章节点到为止,算法讲解未必清晰,想深入钻研的人或许会觉得不够。换句话说,它不是那种可以反复啃的权威参考书,而是一把帮你推开生物信息学大门、看清全局的钥匙。读完你能获得的是「看见森林」的直觉,而非每一棵树的细节。
AI 导读
编辑书评
- 本书的真正价值不在于传授具体的生物信息学技术,而在于搭建一座连接生物学直觉与计算机科学思维的桥梁。它巧妙地避开了晦涩的数学证明,用伪代码和类比揭示了算法设计的本质美感。然而,其局限性同样明显:作为2000年代初的作品,它在处理高通量测序时代的复杂问题上显得力不从心,且缺乏现代软件工程视角下的最佳实践。因此,它不应被视为操作手册,而应作为思维训练场。对于想要理解“为什么这个算法能解决那个生物问题”的初学者,它是极佳的起点;但对于追求实战效率的开发者,它仅是历史参考。
- 与同类书籍相比,Jones和Pevzner的这本书胜在“平衡”。它既不像纯CS算法书那样脱离生物语境,也不像纯生物教材那样回避计算复杂性。这种独特的定位使其成为MIT Press经典系列中的常青树。尽管有读者抱怨其“太浅”或“贵”,但这恰恰反映了其目标受众的精准性——它服务于教育而非工业界。值得推荐的是,在人工智能重塑生物科学的今天,重读此书有助于回归本源,理解数据驱动发现的基本逻辑。建议在系统学习Python/R生物包之前,花两周时间通读此书,它将为你后续的代码调试和问题建模提供不可替代的概念锚点。
核心看点
- 本书核心在于打破生物与计算机的学科壁垒,通过伪代码直观呈现算法逻辑而非堆砌数学公式。它强调少数设计技巧解决大量生物学问题的通用性,适合本科生建立跨学科思维框架,是理解后续复杂生物信息学文献的基石。
- 作为入门教材,其独特价值在于将抽象算法与具体生物问题(如序列比对、基因组组装)紧密绑定。读者能从中看到计算机科学原理如何在生命数据中落地,这种“问题导向”的教学法比纯理论推导更具实践指导意义,尤其适合缺乏编程背景的生物学者。
- 书中对算法的描述采取“浅尝辄止”策略,重在传递直觉(Intuition)而非实现细节。这种取舍虽被部分读者诟病为不够深入,但对于构建知识地图至关重要。它帮助读者快速识别哪些算法适用于何种生物场景,为后续深入研究特定领域节省筛选成本。
读者共识
- 多数读者认可其作为入门教材的价值,认为内容有趣且能温习基础知识。大家普遍反映本书适合作为第一本接触生物信息学的书籍,能帮助建立初步概念,但在深度上有所欠缺,属于典型的“广度优先”型读物。
- 部分资深用户批评算法讲解不够清晰且过于浅显,认为其更像是一本基础算法书而非专业的生物信息学著作。有读者指出,随着时间推移,书中的某些案例和技术显得过时,更适合学生时代阅读,职场人士可能觉得性价比不高。
- 关于适用人群存在分歧:导师强推给本科生入门,但自学者常感困惑。共识在于本书确实降低了跨学科门槛,让非CS背景的人也能看懂算法逻辑,但若想真正动手实践,仍需额外寻找专门的编程教程或更深入的专著。
读者评论
这本书给CS或者bio的学生读都可以啊... 当然bio读的时候, 会发现bio的内容很无聊. cs读的时候, 会发现大多cs的东西很无聊. 作为cs的人, 我感觉只要随便看看里面的题目就好了.
有些章节不够详细,毕竟只是 introduction,不过能给出 problem 和 intuition 也是很好的~
整整看了俩礼拜,内容还算有趣。各个算法说明浅尝则止,入门用是够了。
别闹
其实是一本基础算法书。大概做学生那会儿读起来会更加受用一点---当阅读的时间变得越来越有限之后会常常会有这种感叹。
太浅了。而且算法讲得不是很清晰。
贵死鸟……
温习了高中生物知识,也了解了各种初级的算法
The MIT Press的其他书籍查看全部
 《Essentials of Compilation》
 《Make it Clear》
 《An Introduction to Statistical Genetic Data Analysis》
 《Cloud Computing for Machine Learning and Cognitive Applications》
 《Introduction to Computation and Programming Using Python (2/e)》
 《How Not to Network a Nation》