
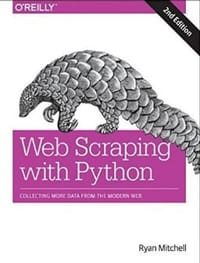
书籍介绍
这本书最打动人的地方,是它把'网络爬虫'从一种灰色技能重新放回阳光之下:作者开篇用谷歌两个斯坦福学生、一台旧服务器起步的故事,告诉你抓取能力本身是中性的工具,真正决定你走多远的,是对法律边界和伦理分寸的判断。它不追求带你深入某个框架的底层,而是用urllib、BeautifulSoup、requests、selenium等常用库帮你快速搭起一张技术地图——解析HTML、翻页、调API、存数据、处理图像与文字识别,覆盖面相当全。读者普遍反馈它'入门但全面',适合已有Python基础、想系统了解爬虫全景再投入实践的人;若指望它解决具体项目里的疑难,则需要自己补齐。一句话:它负责让你安全、合规地跨入门槛。
作者简介
Ryan Mitchell是数据科学家、软件工程师,目前在波士顿LinkeDrive公司负责开发公司的API和数据分析工具。此前,曾在Abine公司构建网络爬虫和网络机器人。她经常做网络数据采集项目的咨询工作,主要面向金融和零售业。另著有Instant Web Scraping with Java。
AI导读
核心看点
- Python爬虫基础与高级实战技巧
- 涵盖数据清洗、API交互及JS渲染
- 强调合法合规与法律风险提示
读者共识
- 内容全面,适合爬虫技术快速入门
- 实战性强,但部分章节深度有限
- 代码简洁规范,需留意版本差异
精彩摘录
- "谷歌在 1994 年成立的时候,就是两个斯坦福大学的毕业生用一个陈旧的服务器和一个Python 网络爬虫。 现在你应该知道了,你已经正式拥有了成为下一个科技亿万富翁需要的工具了!"
- "用 Python 发一封邮件只要 9 行代码: import smtplib from email.mime.text import MIMEText msg = MIMEText("The body of the email is here")、 msg['Subject'] = "An Email Alert" msg['From'] = "[email protected]" msg['To'] = "[email protected]" s = smtplib.SMTP('localhost') s.send_message(msg) s.quit()"
- "Mac系统,首先用 $sudo easy_install pip #安装pip包管理器 然后运行 pip3 install beautiful soup4 #安装库文件"
目录
Learn how to parse complicated HTML pages
Traverse multiple pages and sites
Get a general overview of APIs and how they work
Learn several methods for storing the data you scrape
Download, read, and extract data from documents
显示全部
用户评论
前置条件:有Python基础
内容:简要介绍了爬虫相关的问题,但不深入,相当于破了个题,真正实践中遇到的问题没有涉及。
所以作为爬虫快速入门可以推荐,了解相关技术,再做项目实践深入研究。
豆瓣标的第200本书。
入门教程,但非常全面。NLP, 图像处理,机器学习。最重要的是守法,写爬虫前要先咨询下你的律师
第二版相比第一版加了一点内容(multi-thread etc.)区别不大
读得是最新版,跟老版侧重点有点不同,主要学习了urllib,beautifulsoup,requests,selenium这几个包的用法,读完爬虫差不多能入门了。由于写得比较简洁,对毫无爬虫和网页经验的人来说还是会有看不懂的地方,比如scrapy和API两章,看完也完全不知道在讲什么。
O'Reilly Media的其他书籍查看全部
 Developing Apps with GPT-4 and ChatGPT
 Building Knowledge Graphs
 Essential Math for AI
 Running Lean (3/e)
 Quarkus Cookbook
 Learning React 2nd ed.
求书
收藏