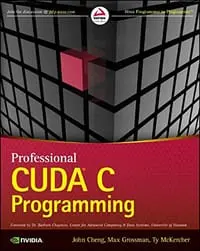
书籍介绍
这本被读者公认为“CUDA by example 之后最好的进阶教材”的书,真正适合的是已经跨过入门、想要系统深入 GPU 编程的开发者。它不满足于教你写出能跑的代码,而是把 CUDA 开发工具的使用、性能分析方法、各类内存(global、shared、constant、texture)的取舍、以及 stream 与 event 的调度都摊开来讲,力求让你“知其然也知其所以然”。书后针对多 GPU 互连(PCIe 单节点与网络多节点)与数据共享场景的讨论,是不少读者特别推荐的亮点。不过它也不是完美无瑕:有读者指出个别章节讲得不够透彻、中文版存在翻译与勘误问题。因此它更像一本值得反复查阅、配合 2-3 本同类书一起啃的“工具书”,而非一气呵成的入门读物。
AI导读
编辑书评
- 本书的真正价值在于它将抽象的GPU架构转化为可操作的编程实践指南,填补了入门教程与专家手册之间的空白。其独特之处在于‘渐进式优化’的教学法,让读者亲眼见证每一行代码改动带来的性能飞跃,这种直观反馈比纯理论阐述更具说服力。尽管出版年份较早,但其核心方法论依然稳固,是构建CUDA工程直觉的最佳读物。
- 局限性在于对最新硬件特性(如Tensor Core、异步拷贝等)覆盖不足,且部分工具链描述已过时。因此,它更适合作为学习并行计算思维和经典优化模式的基石,而非追踪前沿技术的唯一来源。建议在掌握本书核心后,结合NVIDIA最新白皮书进行补充,以应对现代AI加速场景的需求。
核心看点
- 本书构建了从基础语法到高级优化的完整知识体系,特别强调性能分析工具(如nvprof)的实际应用。作者采用渐进式优化策略,先展示未优化代码,再逐步引入内存管理、并行度调整等技巧,直观呈现每一步优化对执行时间的具体影响,帮助读者建立‘测量-优化’的工程思维。
- 深入解析GPU硬件架构与CUDA编程模型的映射关系,重点讲解线程块(Block)、网格(Grid)的调度机制及显存分配原理。通过大量图示和实例,清晰阐释全局内存、共享内存、常量内存等不同存储层级的访问特性及其对程序性能的制约,解决了初学者在资源分配上的常见困惑。
- 涵盖多GPU协同计算、流(Stream)与事件(Event)的高级并行控制以及CUDA库的使用。书中不仅关注单卡性能极致挖掘,还拓展至分布式场景下的数据同步与通信开销分析,为需要处理大规模并行任务的专业开发者提供了从单机到集群的系统性解决方案。
读者共识
- 读者普遍认可其作为《CUDA by Example》之后最佳进阶教材的地位,认为内容细致且覆盖面广。许多用户反馈书中关于Kernel函数编写、显存分配及其性能影响的讲解深入浅出,配有丰富图示,极大降低了自学门槛。
- 部分读者指出书中个别概念解释不够清晰,导致阅读过程中产生纠结感,甚至需要反复研读才能理解。有评论提到,作者写作风格类似‘大厨做菜’,前期铺垫较多,需耐心读完前几章才能体会到后续内容的连贯性和轻松感。
- 高度推崇最后一章及性能优化相关内容,认为这是全书精华所在。读者共识在于:必须养成使用nvprof等工具实时监测的习惯,根据反馈不断调试代码,而非盲目套用优化技巧。这种‘数据驱动’的开发理念得到了广泛认同。
用户评论
挺好的,选择性读过
cuda by example后最好的进阶教材,有中文版
推荐阅读,尤其最后一章!
神书啊。。傻瓜式讲解。。读了这本书真心不可能学不会。。。
@
每当讲解性能优化,作者都会先给出一个性能还没优化的例子,然后每讲一个知识点就优化一点,看看程序优化了多少,是哪方面的优化。刚看完这本书,我认为在写cuda程序的时候应该经常用nvprof看看,根据反馈不断调试cuda代码
Wrox的其他书籍查看全部
 Professional C# and .NET: 2021 Edition
 Professional JavaScript for Web Developers, 4th Edition
 Professional Clojure
 Professional C# 6 and .NET Core 1.0
 Beginning C# 6.0 Programming with Visual Studio 2015
 Professional CodeIgniter